Este projeto parte de um cenário comum em operações críticas. Equipamentos não falham de forma repentina. Eles dão sinais ao longo do tempo.
O problema é que esses sinais ficam espalhados em dados técnicos, difíceis de interpretar no dia a dia.
A proposta aqui foi usar dados de sensores da NASA para transformar esse comportamento em algo simples de ler e agir.
Comecei estruturando os dados de sensores e organizando o histórico de operação de cada motor ao longo dos ciclos.
A partir disso, construí o RUL, que representa quanto tempo ainda resta até a falha.
Em vez de prever um número, transformei o problema em risco. Classifiquei cada momento como baixo, médio ou alto risco.
Treinei um modelo para identificar esses padrões e depois criei um score de risco para priorização.
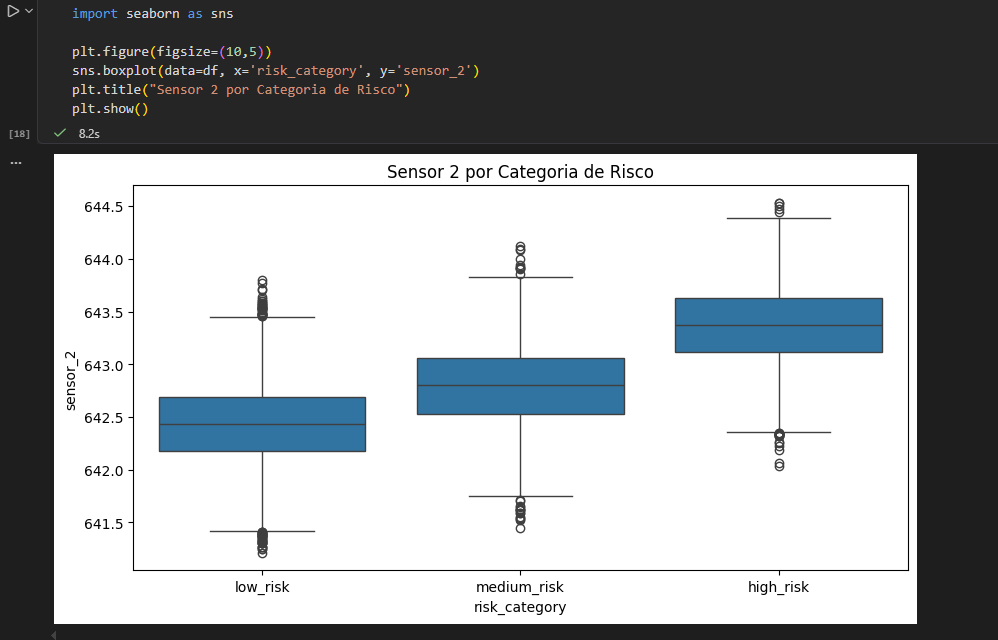
Alguns sensores concentravam praticamente toda a informação relevante. O modelo passou a depender principalmente de poucos sinais.
Motores próximos da falha apresentavam padrões consistentes. Já a zona intermediária era mais difícil de separar, o que também acontece na prática.
O ponto principal não é prever a falha exata. É conseguir priorizar onde agir primeiro.
Com o score de risco, dá para organizar a manutenção de forma mais inteligente, reduzindo risco sem aumentar custo.